英伟达 10 月 2 日披露了 DGX Spark 的 64GB 新版本:10 月 23 日由六家整机厂开卖,起售 4999 美元(约合三万三千元人民币),128GB 的 FE 版同步调整到 6950 美元。这台机器一直被叫作”个人超算”,但把它买回家之前,有一组数字比参数表更重要——内存带宽只有每秒 273 吉字节。
先把事实摆清楚
- 时间和渠道:10 月 2 日官宣,10 月 23 日开售,宏碁、华硕、戴尔、技嘉、惠普、微星六家 OEM 供货,起售 4999 美元;同一天 128GB 的 FE 版价格落到 6950 美元。
- 芯片:GB10 Grace Blackwell 超算芯片,台积电 3 纳米工艺,20 核 Arm v9.2 处理器(10 个 Cortex-X925 加 10 个 Cortex-A725),Blackwell GPU 带 6144 个 CUDA 核心与第五代 Tensor Core,稀疏 FP4 算力标称 1 PFLOP,CPU 与 GPU 之间用 NVLink-C2C 连通,带宽 600GB/s。
- 内存:LPDDR5X 统一内存,64GB 与 128GB 两个版本带宽相同,都是 273 GB/s。64GB 版系统预留约 8GB,留给模型权重与 KV 缓存的空间大约 56GB,支持 NVFP4 量化格式。
- 形态:机身 150×150×50.5 毫米、重 1.2 公斤,被动散热,典型功耗 170 瓦、峰值 224 瓦;内置 ConnectX-7 智能网卡,两个 QSFP56 口,可跑 200Gb/s 的 RDMA。
- 软件:DGX OS(基于 Ubuntu)加完整的 CUDA 加速栈,开箱支持 vLLM、llama.cpp、Ollama、LM Studio 和带 CUDA 的 PyTorch,另附 NVIDIA Agent Toolkit 与 Nemotron 系列开源模型。
一句话读懂它的取舍:这是台容量机器,不是速度机器
273 GB/s 放在 2026 年的桌面设备里是什么水平?大约是 Mac Studio M4 Ultra(819 GB/s)的三分之一、M5 Max(460 到 614 GB/s)的一半左右,只有 RTX 5090(1792 GB/s)的六分之一。
这个差距的直接后果是:稠密模型每生成一个 token,都要把整个模型从内存里读一遍,带宽就等于速度上限;而 MoE(混合专家)模型每个 token 只激活一部分参数,读得少,自然就快。
实测口径很能说明问题:同一台 DGX Spark 上,Qwen3 30B 这类 MoE 模型跑到约每秒 89 个 token,而稠密的 Qwen3 32B 只有约每秒 10.7 个,差了整整八倍。也就是说,27B 以上的稠密模型,生成速度可能慢于你的阅读速度——拿来当原型验证可以,当生产主力不行。
它真正强的是另一头:提示处理(prefill)。因为这段是算力瓶颈而不是带宽瓶颈,官方和第三方测出的数字很夸张,Llama 3.1 8B 每秒能处理七千六百多个 token,gpt-oss 120B 也接近两千。对需要反复喂长上下文的 Agent 工作流来说,这才是价值所在。
64GB 单机能干什么,双机又能干什么
- 单机:设备本地可跑最高约 1000 亿参数的模型。官方给出的顺手清单包括 Gemma4 26B、Qwen3.8-27B、Meta Muse Glimmer、Nemotron3.5 Lightning 等主流开源模型,加载完成后还留有余量给 KV 缓存,能撑长上下文推理。
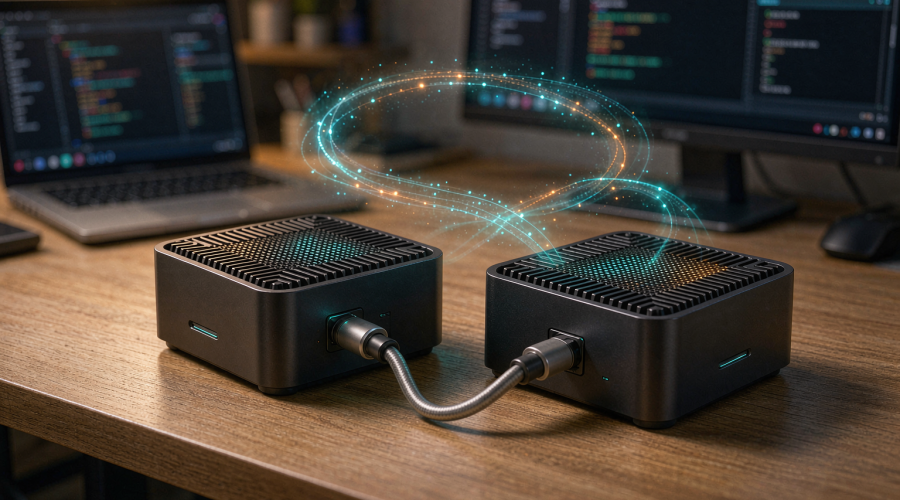
- 双机:两台 64GB 用 ConnectX-7 口直连一根 QSFP 线,内存池化到 128GB,支持模型规模上探到约 2000 亿参数,内存带宽翻倍。官方用 Qwen3.8-27B 实测,双机相比单机最高提升 1.7 倍性能。
- 集群不折腾:NVIDIA Sync 套件里的 Cluster Assistant 会自动做设备检测、配置校验、网络设置和 SSH 部署,最多支持四台组网。开发者还能从普通 PC 远程接入,对接 VS Code、Cursor 这类编辑器,一键启动 vLLM 容器。
- 月底还有两个增量:NVIDIA Sync Model Launcher 让下载和启动 Qwen3.8 27B 变成点几下按钮,还会顺手把 OpenCode 配好,可以直接在浏览器里写代码;Blender 的预编译安装包也在路上。
上手三步
- 选框架:llama.cpp、Ollama、vLLM、LM Studio 任选一个,机器开机即用,官方称从通电到跑起模型只需几分钟。
- 选模型:优先挑 MoE 检查点,别一上来就跑稠密 70B。这一条能决定你第一天是”哇好快”还是”这也太慢”。
- 要扩容再接第二台:两根 ConnectX-7 口之间用 QSFP 线直连,启动 Cluster Assistant,软件环境不用重配。
想少走弯路的,可以直接看官方在 build.nvidia.com 上放的 OpenClaw 本地智能体实战指南,它把这台机器跑编程 Agent 的完整链路都写好了。
它真正的对手是 Mac Studio,不是云
第三方做过一组很有意思的对照:双 DGX Spark 集群(合计 256GB)对上 256GB 统一内存的 Mac Studio M5 Ultra。
- 长提示处理:拿一份真实的 14 文件 Python 代码库当输入,32000 token 时双 Spark 用了 17 秒,Mac 约 50 秒,差约 3 倍;到 128000 token,Spark 约 72 秒,Mac 干脆没测,因为趋势预示要三分多钟。
- 生成速度反过来:短提示下跑 DeepSeek,两边都是约 38 tok/s;跑 Qwen 时 Mac 45、Spark 38——带宽优势在生成阶段兑现。
- 多用户行为分岔:Mac 的合并吞吐在约 4 个并发时见顶(约 66 tok/s),到 8 个并发掉到 46;Spark 集群在测试区间内继续往上走。
- 价格几乎打平:两台 Spark 各约 5000 美元再加一根 RoCE 线,和一台高配 Mac Studio 落在大致同一档。所以决策看的不是谁便宜,而是你的工作负载是什么形状。
如果你只是想跑 27B 以内的小模型练手,站内那篇阿里开源 Qwen3.8-27B 的本地部署说明提到的配置已经够用,不必上这台机器;而Meta Muse Glimmer 的本地化思路则说明了 2026 年”一块显卡跑 300 亿参数”这条路线为什么突然火起来。
优缺点
优点:一是统一内存容量是同价位消费级显卡的四倍以上(RTX 5090 只有 32GB 显存,这里单机就能给到 128GB);二是 CUDA 生态完整,需要微调时工具链基本都指向它,官方定位支持 70B 以内的微调;三是提示处理快、多用户可扩展,适合 Agent 反复啃长上下文;四是把数据中心级的 200Gb RDMA 下放到了桌面。
缺点:一是 273GB/s 的带宽是硬伤,稠密模型生成慢,别指望它替代显卡;二是 64GB 版实际可用约 56GB,能跑的模型比标称少一档;三是中文资料和中文社区支持偏薄,遇到问题多半得翻英文文档;四是它需要”两台一起买”才能发挥集群优势,单机的想象空间有限。
适合谁 / 先别急
适合:要做 70B 以内微调的团队;要给编程 Agent 长时间提供本地长上下文;团队多人共用一台本地推理机;数据不能出内网、对合规有硬要求的场景。
先别急:主力模型都在 27B 以下的;只做短提示长输出的写作类任务;预算有限的个人开发者;对延迟敏感的实时应用。
替代方案四个
- Mac Studio M5 Max 128GB:带宽更高、生成更快、起步价更低,代价是没有 CUDA,微调生态要绕路。
- RTX 5090 主机:生成速度最快,但显存只有 32GB,大模型装不下,只适合小模型高速推理。
- 云 API:最省事,长期算下来未必更贵。只有”数据不出内网”和”反复吃长上下文”这两个场景,本地机才真正划算。
- 上一代统一内存整机(如 AMD 一系的小体积方案):价格更低,同样能装大内存,但 CUDA 生态缺失,很多工具要自己编译。
老达之前评测过的同类本地化方案,都整理在 AI 工具评测专题里,买之前值得横向翻一遍再决定。
老达点评
- 64GB 版的意义不是便宜,是把门槛降了一档。原来”本地跑大模型”要么两台起、要么上工作站,现在可以先买一台试试水,这是这次更新最实际的地方。
- 请记住 273GB/s 这个数。它不是缺点,是产品定义——英伟达卖的是容量和生态,速度交给集群去解决。搞错了预期,买回来就会失望。
- 别拿它和云 API 比单价。它省的不是钱,是”数据不出门”的确定性;如果你的数据本来就可以上云,这笔账很难算平。
- 真正值得等的不是机器,是软件。月底的集群助手和模型启动器落地后,这台机器的实际易用性会有一次跳变,硬件本身三个月内不会有惊喜。