AI Agent 干活最常卡在哪?不是不会点,是登录不上。
Playwright、Selenium 这类工具开出来的浏览器是全新的:没有 Cookie、没有会话、没有你公司内网的通行凭证。于是每次自动化任务的第一步,都变成了重新登录——要验证码就得找人,要二次确认又得找人,跑两下还可能触发风控。
9 月 17 日,腾讯开源了一个专治这件事的项目:BrowserSkill。它的思路不是让 Agent 更聪明,而是换一个前提——别给 Agent 开新浏览器,让它借用你已经登录好的那个。
一、先看它解决的是什么问题
大部分 Agent 浏览器方案都卡在同一个地方。把几条常见路线摆一起就清楚了:
| 方案 | 登录态 | 是否占用你的浏览器 | 卡验证码时 |
| — | — | — | — |
| Playwright / Selenium | 需自建账号或重新登录 | 独立无头实例,不占 | 直接失败 |
| 接管整个浏览器 Profile | 有,但要交出浏览器 | 完全占用,你没法干活 | 直接失败 |
| 各家 Agent 内置浏览器 | 通常是隔离沙箱 | 不占 | 脚本里人工兜底 |
| BrowserSkill | 复用你当前登录态 | 独立 Agent 窗口,不占 | 主动请你接管 |
BrowserSkill 选的是最后一条:Cookie 天然共享,但因为跑在独立窗口里,你手上的标签页一个都不会被抢走。
二、它是怎么做到的:三个组件,全走本地
架构不复杂,但每一层都很克制:
- bsk 命令行工具:Agent 真正调用的入口,所有操作都是一条 shell 命令
- 本地守护进程(daemon):负责进程间通信与调度,默认自己管理生命周期
- 浏览器扩展:真正去操作浏览器的那个,官方支持 Chrome 和 Microsoft Edge
调用链是 Agent → bsk → daemon → 扩展 → Agent Window。其中 daemon 到扩展这一段走的是绑定在 127.0.0.1 的 WebSocket,全程本地、无远程遥测、不上传凭证——这也是它能理直气壮接管登录态的前提。
有两条设计细节值得单独说:
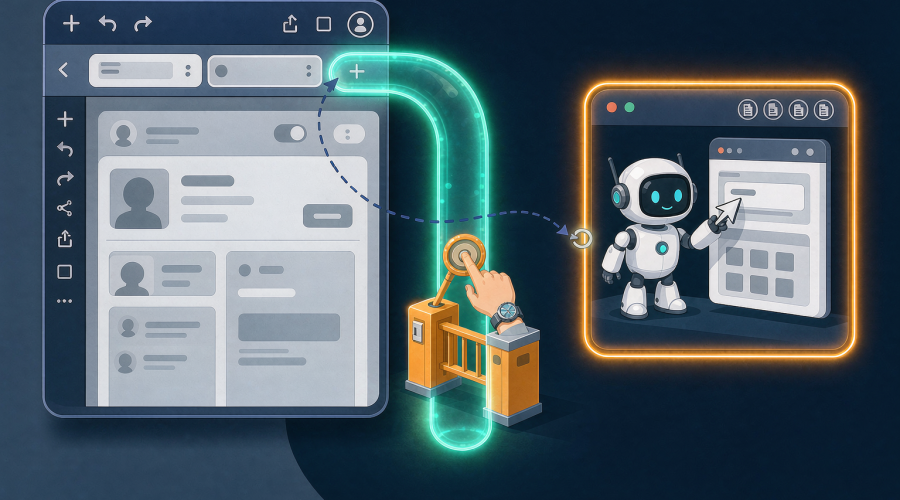
Agent Window 是独立的。 扩展会在你正在用的 Chrome/Edge 里开一个单独窗口,带明显的橙色高亮标识。你继续刷网页、回消息、开会,Agent 在旁边那个窗口里干活,互不干扰。
标签页是「借」的,不是「占」的。 如果任务需要操作你已经打开的那个标签页,必须显式借用,任务结束后归还。这条规则听起来啰嗦,实际是这套方案能落在真实工作流里的关键——它默认假设你的浏览器有主。
三、它不绑定任何 Agent
这是我认为最值钱的一点:BrowserSkill 是一个 CLI,不是一个 MCP Server,也不是某个框架的插件。
只要你的 Agent 能执行 shell 命令,它就能用。 官方列出的适配清单包括 Cursor、Claude Code、Codex、OpenClaw、CodeBuddy、WorkBuddy、Pi、Hermes Agent、DeepSeek Harness——顺带说一句,WorkBuddy 就在列表里,也就是说你现在这套工作流理论上可以直接接上。
换工具不用重写脚本,这在浏览器自动化这个赛道上算是稀缺品质。
四、上手:三步,或者干脆让 Agent 自己装
推荐做法是让 Agent 自己装。把这句话发给它就行:
按照 https://raw.githubusercontent.com/Tencent/BrowserSkill/main/AGENT_INSTALL.md
的说明,在本机安装并配置 browser-skill
手动装也不难,四步:
1. 装 bsk 命令行
macOS / Linux:
curl -fsSL https://raw.githubusercontent.com/Tencent/BrowserSkill/main/install.sh | sh
export PATH="${BSK_INSTALL_DIR:-$HOME/.local/bin}:$PATH"
Windows(PowerShell):
irm https://raw.githubusercontent.com/Tencent/BrowserSkill/main/install.ps1 | iex2. 从 Chrome Web Store 或 Edge 加载项商店装浏览器扩展。
3. 把 skill 注册进你的 Agent。
bsk install-skill交互式选 Agent 框架;也支持非交互模式,比如 bsk install-skill --harness cursor --json。
4. 体检。
bsk --version
bsk doctor
bsk doctor 会检查三件事:命令行、守护进程、扩展配对状态,缺什么直接告诉你。确认扩展弹窗显示已连接,就可以开工了。
一次典型会话大概长这样:
bsk session start --json
bsk navigate https://example.com --session <id>
bsk observe --session <id>
bsk click @e3 --session <id>
bsk fill @e3 --value "内容" --session <id>
bsk screenshot --session <id> --full-page --out page.png
bsk session stop
五、真正好用的几个细节
用元素编号操作,而不是整页截图。 bsk observe 返回的是一棵带编号的可交互元素树,Agent 拿到之后直接 click @e12。比起把整页截图喂给模型,这条路明显更省 token,也更稳定——不会因为页面渲染慢半拍就点错位置。
Human-in-the-Loop 是真做进去了。 遇到验证码、登录确认、短信验证这类自动化天生搞不定的环节,Agent 会主动暂停并请你接管,你处理完它接着跑。这个设计和 给后台 Agent 配收件箱、要动手先审批 是同一个思路:把「必须由人做」的节点显式设计出来,而不是靠脚本硬扛。
长截图和鼠标滚轮这类基础件补齐了。 全页截图支持超时控制与取消,还有真实的滚轮事件、focus/blur、滚动到指定元素——这些听起来琐碎,但没有它们,Agent 在长页面和懒加载页面上基本没法用。
0.3.0 新增了 canvas 支持和远程网关。 扩展能识别 canvas 候选并返回可点击的视觉引用,配上可见区域截图;还支持带认证的远程浏览器连接与后台任务标签页。版本更新挺密:命令行、扩展和插件三者统一走 0.3.0。
平台覆盖到齐。 macOS(Apple Silicon / Intel)、Linux(x64 / ARM64)、Windows x64 都有构建产物。浏览器官方支持 Chrome 与 Edge,其他 Chromium 内核通常也能用,Firefox 目前还只是计划中。
六、说清楚局限,别踩坑
任何方案都有代价,BrowserSkill 的代价很具体:
你多了一个必须活着的本地服务。 浏览器要开着、扩展要连着、daemon 要健康,三者缺一任务就起不来。对个人开发者无所谓,但如果你习惯把 Agent 塞进一次性容器里跑,这套就得额外配置:把守护进程钉在一台常驻主机上共享 BSK_HOME,再把 BSK_AUTO_START 设成 0,从沙箱里连过去。官方文档给了这条路径,但它确实是运维成本。
扩展的权限范围不小。 它要读和写你的标签页、复用你的登录 Cookie。源码是开放的(TypeScript,MIT 协议),也有可选的操作审计(本地存储、脱敏、保留 30 天),但真要在团队机器上铺开,安全团队是绕不过去的一环。
登录态复用本身就是风险放大器。 这一点值得格外清醒:让 Agent 拿到你的登录会话,意味着它能碰到的东西和你一样多。恶意 Git 仓库能一次性攻破 7 款 AI 编程工具 的教训就在眼前——把权限交出去之前,先想清楚边界在哪,也和 给 AI 编程 Agent 收权限 的逻辑一致:能小则小。
并发和规模不是它的战场。 它是为「一个 Agent 在真实浏览器里老老实实干完一件事」设计的,不是为大规模爬取或压测准备的。
七、适合谁用
适合:
- 重度使用 Cursor / Claude Code / Codex,想让 Agent 帮忙操作已登录后台的开发者
- 需要 Agent 操作飞书、GitHub、公司内网这类必须登录的系统
- 做已登录页面的自动化回归测试
- 想把网页抓取、表单填写、内容总结串进日常流程,又不想维护一堆测试账号的人
不太适合:
- 需要成百上千并发任务的批量作业
- 完全无头、无人值守的 CI 流水线(除非按上面那套常驻主机方案改)
- 只用 Firefox 的用户
替代方案:如果你只是想在浏览器里做通用操作,OpenAI 的 WebMCP 走的是另一条路——让网站主动把按钮声明成工具接口,Agent 不用猜着点,但前提是网站愿意配合。而 Claude Cowork 内置浏览器 则是把浏览器能力收进自家 Agent 里,闭环但不可替换。BrowserSkill 的位置刚好在两者中间:不要求网站改造,也不绑定 Agent。
老达点评
对这个项目,我有三个判断。
第一,选 CLI 而不是 MCP,是刻意为之。 MCP 生态这两年在快速统一工具接入,但 BrowserSkill 偏要走命令行。原因很直白:CLI 是唯一所有 Agent 都默认支持的接口,没有之一。MCP 方案要先解决配置、授权、传输这些前置问题,而 bsk 一条命令就能被试出来。在这个「先让人用上」的阶段,这个取舍是对的。
第二,它把「人的登录态」当成了可信上下文。 过去两年 Agent 浏览器方案都在死磕「怎么让模型点得更准」,BrowserSkill 绕过去问了一句:为什么不直接站在用户的会话里?这个问题问得挺聪明——重复鉴权本身就是自动化最大的成本项,而它选择把这个成本一次性消掉。
第三,Human-in-the-Loop 正在成为分水岭。 验证码交回用户、标签页显式借用、任务结束归还,三件事指向同一种产品哲学:AI 能做的让 AI 做,必须人做的明确留给人。反过来看,那些号称「全自动」却让人事后收拾烂摊子的方案,问题往往不在能力,而在没设计好交接点。
对国内团队来说,这是个值得花半小时试的基建补丁——尤其如果你已经在用 Agent 处理有登录态的内部系统。想再往深走一层,AI 智能体与自动化专题 里有一批 Agent 接入真实系统的案例;如果关心怎么把浏览器能力接进编程工作流,AI 编程工具专题 也可以一并收着。另外,把异步任务交给 Agent 这个思路,我之前用邮箱远程调度 Codex 那套土办法和今天的 BrowserSkill 其实是同一件事的两代解法。
常被问到的几个问题
Q:它和 Playwright 是什么关系?
不是替代关系。Playwright 是给你写测试脚本用的编程库,BrowserSkill 是给 Agent 用的操作接口。前者你自己写代码控制,后者让 Agent 自己决定点哪。
Q:需要把浏览器密码交给 Agent 吗?
不用。它不接管你的账号密码,只是复用浏览器里已有的 Cookie 和会话。Agent 拿到的是「已登录的页面」,不是凭证本身。
Q:Agent 会乱动我的标签页吗?
默认不会。所有操作都在独立的 Agent Window 里,需要操作你已打开的标签页时必须显式借用,任务结束后归还。
Q:企业环境能用吗?
能,但要过两道关:一是安全评估(扩展权限和本地守护进程),二是运维方案(常驻主机或 CI 沙箱配置)。个人机器上基本没有额外负担。
Q:免费吗?
是。MIT 协议开源,可商用、可二次开发。