9 月 23 日,谷歌放出两款新的文字转语音模型:Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS。官方在发布稿里的定位是”把语音生成从静态预设变成一个动态的创作工作室”。
这句话不算夸张。上一代 Gemini 音频家族的音色库只有 30 个原始声音,而这次直接给到 2000 多种成品音色,同时开放了”用文字描述造一个新音色”和”用 30 秒样本克隆声音”两条路。
发布时间点也有意思:就在同一个星期,OpenAI 和 Anthropic 正在为每百万 token 的价格对打出牌,谷歌选的切口是语音——一个没被卷过、但需求真实存在的位置。
一、这次到底能干什么
两款模型的定位分工很明确:
- Gemini 3.8 Flash TTS:面向创作,游戏角色、有声书、播客、互动媒体。可以用一句自然语言描述造音色,比如”墨尔本的高能电台 DJ””一条日本龙”,官方支持 130 种语言。
- Gemini 3.8 Flash-Lite TTS:便宜、扛量的那一款,面向批量配音、视频本地化和语音助手,支持 101 种语言。
两款共用一套接口 schema,模型 ID 分别是 gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts,输入上限 8192 token、输出 16384 token。开发者在 Gemini API 和 Google AI Studio 里当天就能用,Gemini Enterprise 的企业通道写的是”即将开放”。
具体能力有几项值得单独说:
逐行导演。 脚本里可以直接写舞台指示,控制每一句的语速、方言和情绪;单份脚本就能演双人对话,自动处理轮次切换;还能插入笑声、叹气这类非语言提示,以及”嗯””对”这种听起来在认真听的反应词。官方称连续几小时的音频里说话人漂移很小。
两千多种成品音色。 包括墨西哥西班牙语、魁北克法语、苏格兰英语这些地区变体。造好的自定义音色可以存下来复用——对每周更新的播客来说,这一点比跑分更实用。
音色混音(即将上线)。 对库存音色做音色、音高、语速、口音层面的微调,目前还没开。
二、跑分和生态:谁来接
谷歌报的成绩全部来自第三方评测机构 Hume AI:
- Flash TTS 在 Voice Design Benchmark 上以 71.4 分排第一
- 口音建模一项 60.8 分,同样领先
- Flash TTS 和 Flash-Lite TTS 在 Hume 的整体质量指数上分列第一、第二
- 在 Voice Arena 的盲测里,日语、巴西葡萄牙语、越南语、现代标准阿拉伯语、墨西哥西班牙语、印地语这几个语种上排到前列
需要说明的是,这些都是谷歌自己引用的第三方成绩,不是独立复现。
生态侧名单也不短:Figma、HeyGen、Linguana、Wondercraft、99.co、Ollang 已接入,用于配音、本地化和对话式语音助手;开发者平台侧有 Agora、LiveKit、Pipecat、Vercel 支持基于 Gemini API 部署。
面向普通用户的分发路径分两条:Flash TTS 进 Gemini Notebook,Flash-Lite TTS 进 Google Vids。
三、语音克隆的安全设计:30 秒 + 一句口头同意
这是整篇发布里限制最多、也最该讲清楚的部分。
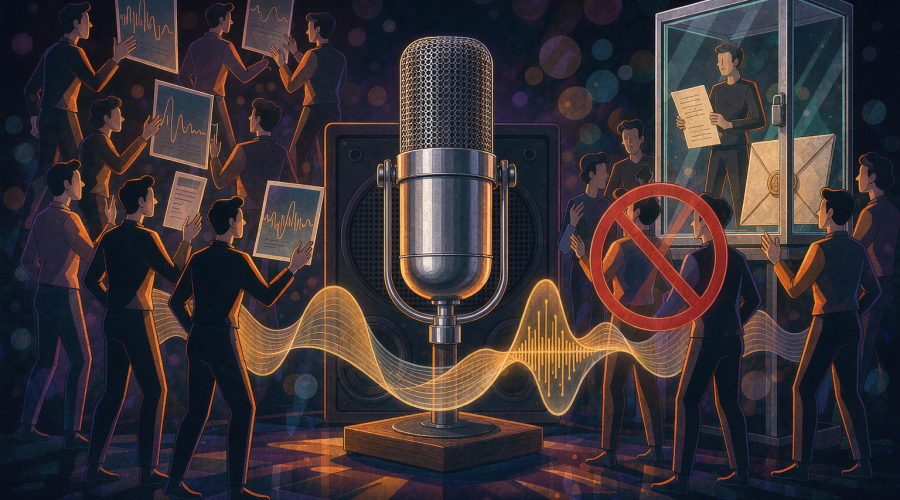
克隆真人声音只需要大约 30 秒的样本,但前面加了一道闸门:必须提供声音本人录的一句口头同意,系统会先校验这段同意录音和参考说话人是否一致,通过之后才允许生成。
输出侧的约束是双层的:所有 Gemini Audio 模型生成的音频都带 SynthID 隐形水印,克隆出来的声音还额外带 C2PA 内容凭证。
地域限制值得留意——通过 AI Studio 做语音克隆,在伊利诺伊州、得克萨斯州、欧洲经济区、英国、瑞士和印度都不可用。
水印这件事也要客观看:《ElevenLabs AI 配音教程》里介绍过克隆声音的实际效果,而水印在音频被反复重编码之后会衰减;同意校验也只能拦住老实人。也就是说,这套机制解决的是”可追溯和可举证”,不是”防止被滥用”。真正防滥用的还是那一层——你的原始音频别乱传。
四、和 ElevenLabs 这类专业工具比,差在哪
语音合成不是新赛道。ElevenLabs、印度的 Murf AI 早已在做,Adobe 也在 8 月把语音生成加进了 Firefly。谷歌这次进场,优势和短板都很清楚:
优势:一是生态,音色能直接接进 Figma、HeyGen、Wondercraft 这些已经在用的工具链;二是价格结构,虽然官方页面没有公布任何美元标价,但按谷歌一贯的打法,Flash-Lite 档大概率会走低价高量;三是多语种覆盖广,130 种语言对做海外内容的团队是硬需求。
短板:一是企业采购通道还没开,10 到 200 人规模、没有专职开发的公司现在只能走 Agora、LiveKit 这类合作平台;二是音色质量控制的上限还需要实测,长音频的角色一致性目前只有官方说法;三是克隆功能的地域限制比竞品更严,中国大陆和欧洲开发者暂时用不上这条路径。
五、老达点评
一、谷歌把 TTS 的竞争点从”像不像人”换成了”好不好调度”。 逐行导演、非语言提示、双人脚本、音色可复用——这几项不是音质改进,是创作流程改进。对做播客、有声书、出海视频的人来说,工具能不能被编排,比某个音色像不像真人重要得多。
二、同意验证这道闸门,是这次最有价值的工程细节。 语音克隆被滥用的新闻每年都有,行业里的通行做法是事后声明,谷歌做的是事前校验。它拦不住所有人,但把”我授权过”变成了一个可验证的动作,这个思路值得被抄到视频换脸、声音翻唱这些场景里去。
三、”没公布价格”本身就是一条信息。 一个只在 API 层发布、企业通道还没开的产品,定价通常要等到企业侧谈完才落地。急着上生产的话,先按合作平台的报价做预算,别按 Gemini 主线的价格去估。
六、想试的话,四步走
- 去 Google AI Studio 挑一个现成音色,用一段 200 字的中文脚本试逐行导演,感受一下控制粒度。这一步零成本。
- 测你自己的长内容:拿一期已经录好的播客,转成脚本重跑一遍,重点听第 20 分钟之后有没有音色漂移。
- 多语种对照:同一份脚本分别跑中文和英文,判断值不值得替掉现在的外包配音。
- 克隆功能先别急:它需要本人录制同意声明,且在中国大陆不可用。如果你要的是自己的固定声线,先在本地留好原始录音,等通道开放。
如果只是做中文短视频配音,国内的选择也够用——阿里 Qwen3.8-Omni-Flash 把音视频输入的接口价格降了九成以上(《阿里 Qwen3.8-Omni-Flash 上线》),音画一体的活它更顺手。想要专业音色的,可以对照那篇《2026 年 AI 配音副业完全指南》里的接单路径,先看客户要什么再选工具。批量做视频的还可以顺手看看《达芬奇 21.1 原生接入 Claude 和 Codex》这类剪辑侧的变化,配音和剪辑正在同一批工具链里合流。
想跟谷歌这条产品线,站内那篇《Gemini 3.8 Flash 发布》讲的是本月早些时候的同族模型,可以和本篇对着看。更多工具类实测,见 AI 工具评测专题 和 老达 AI 实践专题。