便利店里最烦的活不是收银,是挂货。
一排挂钩,位置固定,标签牌挡在前面,商品包装软硬不一。人做这件事靠手感和余光,机器人只能靠视觉。
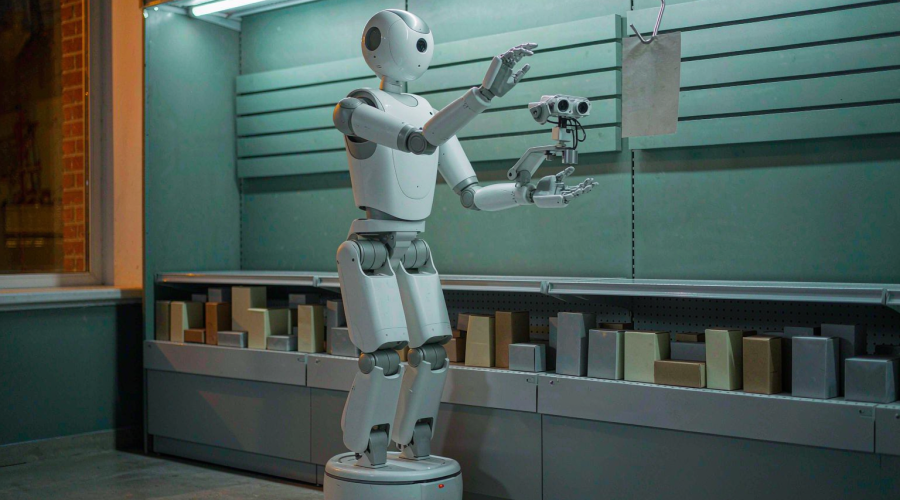
十月二十七日,智元发布具身 Agent 框架 Genie Master,给的第一个案例就是这个。搭载框架的精灵 G2 在真实便利店里挂不上去,回头翻了自己的失败记录,发现头部相机分辨率不够、挂钩又被标签牌遮住,于是换了打法:左手先靠近目标,用腕部相机补一张近距离的图,确认位置之后,右手再挂。
这段描述里最值钱的是最后半句——这次调整是它自己做的,旁边没有工程师在改代码。
它要解决的不是「会不会」,是「做砸了怎么办」
今天大多数机器人的工作方式,像一个考前背答案的学生:在实验室或仿真里把动作练熟,然后整段搬到真实场景。
可真实世界不按剧本走。挂钩换了尺寸、标签牌挪了两厘米、外卖袋的白色提带缠住了夹爪——只要碰上训练时没见过的情况,传统做法就是工程师重新采数据、调模型、写规则,机器人停在原地等补课。
这条路径的成本不在技术,在节奏。一家店出问题,一家店停摆;一百家店出问题,一百个工程师排队。智元把这件事叫 Physical RSI,具身递归自进化:让机器人在部署之后自己补课,把每一次失败变成下一次的依据。
听起来像概念包装,但它至少给了一个具体机制,而不是一句愿景。
EEP:先把「怎么问、怎么答」定下来
支撑整套闭环的是智元提出的具身执行协议 EEP,全称 Embodied Execution Protocol。它统一了四类接口。
能力:这台机器人现在会什么,能调用哪些工具。相当于给人一份工具清单,而不是含糊地说「你去干活」。
引导:这一步该怎么动,先做什么后做什么。
反馈:做完没有,卡在哪一步,是成了还是没成。这条是关键——很多机器人系统只回「成功/失败」一个布尔值,等于什么都没说。
连续性:还有哪些任务没做完,中断之后从哪儿接。
四类接口听起来朴素,落到工程上解决的是同一个老问题:Agent 和本体之间缺一套共同的结算语言。 没有它,模型再聪明也只能猜自己刚才那一下有没有到位。
有了这套语言,任务中断时系统会保留已完成的进展,Agent 从断点重新规划,而不是从头再来一遍。多台机器人一起干活时,Agent 还能追踪分工和任务依赖,做动态调度。
两个案例,把闭环讲完了
挂货。失败原因不是「抓取力不够」这种笼统判断,而是很具体的一条:头部视角分辨率不足,目标被标签牌遮挡。于是调整引导——左手先靠近,腕部相机补视角,确认后再右手作业。从「挂不上」到「为什么挂不上」再到「应该怎么挂」,三步都留了痕迹。
打包外卖。水瓶和夹爪容易被白色提带缠住。Agent 给出的调整是把动作提示写得更细:夹爪先收回,再重新尝试放进包装袋。这类「出问题—调整—结果」的配对数据,后面会被拿去训练动作策略。
两个案例选得挺聪明。它们都不是大开大合的展示动作,而是那种只有真在店里站过八小时才会遇到的琐碎故障。演示视频里看不见的,恰恰是这层东西。
两层 RSI:一层记笔记,一层练肌肉
这是全文我最愿意花时间讲的部分,因为它区分了两种完全不同的「学习」。
Harness RSI,记笔记。 机器人在推理和执行过程中,把成功与失败的案例随做随记。每天收工后由模型统一复盘,把可复用的部分沉淀进长期记忆。下次遇到同类任务,先翻笔记再动手。
Policy RSI,练成肌肉记忆。 执行、接管、恢复的过程中会产生大量「问题—调整—结果」数据,这些数据经过后处理拿去训练动作策略,让有效的改进不只服务于当次任务,而是进入模型参数,变成下次不用想就能做对的本能。
两层的关系不是并列,是分工。第一层解决「想明白」,第二层解决「做顺手」。只做第一层,机器人会变成一个很会总结但手很笨的家伙;只做第二层,遇到没见过的问题它连总结的机会都没有。
这套分法在软件世界里其实早就有了:一层是上下文里的记忆和提示,一层是权重里的能力。区别在于软件改权重便宜,机器人改策略要过一遍真机数据,慢得多,也贵得多。
哪些能核实,哪些只有厂商说法
这条线得划清楚,不然容易被「行业首次」四个字带跑。
能核实的:十月二十七日发布,属于 AI WAVE 期间的第四项发布;框架名 Genie Master;搭载机型精灵 G2;场景是真实便利店,任务覆盖熟食打包、取货、补货;EEP 的四类接口定义如上;十一月二日将开二十四小时不间断直播,六台 G2 分午间高峰、晚高峰、深夜值守、清晨早餐四个班次连续作业。
只有厂商说法的:改善幅度。官方表述是熟食打包「多次失败后变得更顺畅」、取货补货「准确度稳步提高」,但没有一个具体数字——没有成功率曲线,没有干预次数,没有平均完成时间。门店数量也没说,是一家店还是多家店,同样没交代。
属于宣传口径的:「行业首次在真实业务场景中验证 Physical RSI」。这句话的成立条件取决于怎么定义「验证」——是一次挂货任务的自我修正,还是连续多周的稳定改进,两者不在一个量级。
这不是挑刺。恰恰相反,十一月二日那场直播本身就是一种交代:把六台机器人和四个班次摊在镜头前面,等于把考卷公开了。能不能过,看得见。
对做软件智能体的人,这套东西可以直接借
如果你不做机器人,这篇也不是白读。EEP 那四类接口,几乎可以一对一映射到软件 Agent 的常见缺口上。
能力清单对应工具 schema。你的 Agent 知不知道自己有哪些工具、每个工具的边界在哪。
引导对应计划。不是一句「帮我处理一下」,而是这一步先做什么、后做什么。
反馈对应结构化结果。不是 success: false,而是失败在第几步、原因是什么、已完成的进度保住了没有。
连续性对应任务状态。这一点站内前几天刚写过两条相邻的线:AWS 开源的 Infinity 把工具调用当 await 点,等结果时把智能体整个挂起,靠的是可持久化的任务状态;Vercel 的 durable-harness 解决的是崩溃之后从断掉那一行接着跑。机器人这边的「保留已完成进展、从断点重规划」,本质是同一个问题在物理世界的版本。
而 Harness RSI 与 Policy RSI 的分工,也照见了软件智能体的两条老路:一条拼命加长上下文、堆记忆,一条微调模型。两层都做的人不多,因为第一层见效快、第二层要数据。智元的选择是两个都要,代价是必须真把机器人放到店里去跑。
想把这套思路放回软件世界,可以从 AI 智能体与自动化专题 顺着捋;如果你更关心「智能体凭什么算能干完活」,老达AI实践专题 里的几篇更偏方法论。
老达点评
一、「自己写错题本」这个比喻,比 Physical RSI 这四个字母有用得多。 一堆缩写堆在一起,读者记不住;但一个会记错题、会复盘、会把错题练成肌肉记忆的机器人,画面感立刻就出来了。技术传播里,好比喻的价值经常高于好名词。
二、真正难的不是自我改进,是自我判断。 机器人怎么知道这次「算成功」?挂上去了算成功,还是挂上去且没刮花包装算成功?反馈接口定义了什么叫达标,这一步定歪了,后面两层 RSI 都在放大错误。软件世界里的对应物是评测标准——站内写过微软把几百次 Agent 会话总结成九类翻车模式,说的也是同一件事:能跑通,不代表是对的。
三、没有数字,就还只是机制说明。 我认可这套设计,也认可十一月二日公开直播的诚意,但「更顺畅」「稳步提高」这种表述,读者没法据此判断它到底行不行。如果要我提一个要求,就一个:直播之后给出四个班次的干预次数和失败率,哪怕是难看的数字。具身智能这几年最不缺的就是漂亮的演示,最缺的是敢公布的曲线。
四、这条路的终局是边际成本,不是单店表现。 一台机器人在一家店里越干越熟,这件事本身不新鲜;新鲜的是「经验能不能复制到第二家店」。Harness RSI 的经验存在记忆里,能不能整包搬到隔壁门店?Policy RSI 练出来的策略,换一个货架布局还成立吗?智元说接下来会在更多任务和场景里继续检验——这句话才是关键,比发布本身重要。四月的具身智能综述里就提过,量产不是门槛,复制才是;英伟达 Isaac ROS 5.0 解决的是造机器人的工具链,智谱把融资押在 RSI 上 解决的是模型自己教自己,智元这次补的是「上岗之后」这一段。三段拼起来,才是一条完整的路。
真要给一个判断:这件事值得盯着看,但现在还不值得下结论。十一月二日那二十四小时,比十月二十七日这场发布会更有信息量。