十一月十七日,微软在旧金山开 Ignite,一天放出七款自研模型。
排在最前面的是两个编码模型:Code 2 和它的小号 Code 2 Flash。台上反复引用的三个数字是——拿到对手九成八的质量,只花四成的钱;面对另一家的旗舰,只花百分之五。
这三个数字都是真的。只是底下压着一行小字:以上成本按五折促销价计算。
先拆第一个数字:九成八是四项平均
四项基准,取平均:DeepSWE 1.1、Terminal-Bench 2.1、SWE Atlas、FrontierCode v1.1。
Code 2 拿到六十三点二,GPT-6.1 Sol 六十四点一,Claude Opus 5.5 六十五点三。两个比值就是官方那两句「九成八」和「九成六」,算术没问题。
三项跑在微软自家的 MSBench 上,用的是 Copilot 命令行一点零点一零二版,子智能体关掉,推理档拉到最高,每题三次取均值,基础设施报错算失败。
这套方法本身挺扎实——把「报错不算」和「只挑最好那次」两种常见注水手法都堵上了。真正要留意的是另一半:评测台、工具链、模型,三样都属于同一家。
站内写过 Copilot 把「选模型」换成「选档位」的那次改版(六毛一解决七成,四块九毛七解决七成八),当时的结论是最贵那档最不划算。微软这次给的是另一个答案:不比谁更聪明,比谁在同样的活上更便宜。
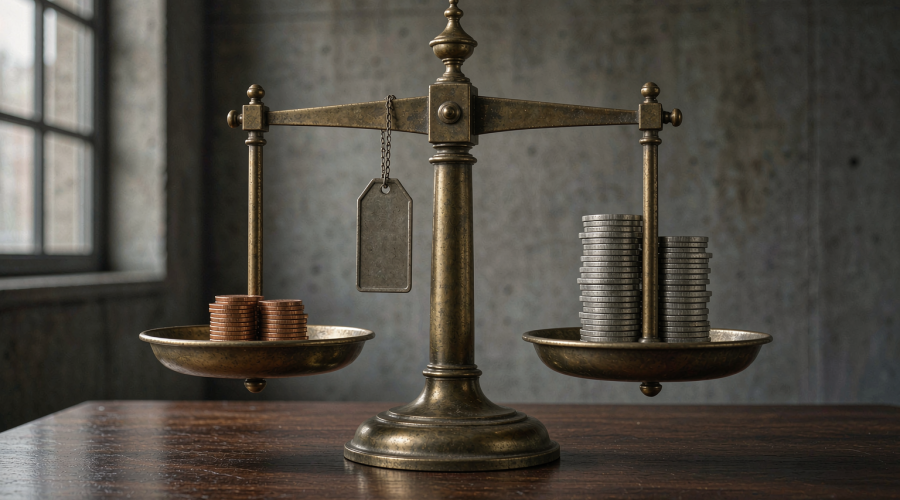
价目表摊开,翻倍的日子已经写好了
促销价和正价并排:
输入,五十美分对一美元。缓存输入,两点五美分对五美分。输出,两块五对五块。计价单位是每百万 token。
翻倍的那天是二〇二七年五月十七日。
做个对照:GPT-6.1 Sol 是两美元进、十美元出;Opus 5.5 是四美元进、二十美元出。上周谷歌把 Flash 这个名字埋了,Hydrogen 的标价是一块五美元进、七块五美元出(Flash 这个名字被悄悄埋了)——按正价算,Code 2 比它还便宜一档。
这里有个数最该被记住:缓存输入两点五美分,是输入价的二十分之一。改代码这活,同一份仓库会被反复读进去,绝大多数 token 走的是缓存那一档。谁只盯输出的价签,谁就算不准。
一天三百次任务,账是这么走的
官方给的单次任务成本:Code 2 零点三零九美元,Sol 零点七六一,Opus 5.5 是六点三零六。
按一天三百次、一个月二十二个工作日算:
Code 2,一个月两千零三十九美元,约一万四千七。Sol,五千零二十三美元,约三万六。Opus 5.5,四万一千六百二十美元,约三十万。
差二点五倍,差二十倍。这就是「五分之一」的全部来源。
翻倍之后呢?Code 2 每次零点六一八,一个月四千零七十九美元,约两万九。
跟 Sol 的差距,从「便宜六成」变成「便宜一成九」。
一句「便宜八成」变成「便宜两成」,中间没有任何技术变化,只有日历翻了一页。
轻量那档最尴尬:正价比它要打的那款还贵
Flash 的价目不一样:促销五美分进、二十五美分出,正价十美分进、五十美分出。
官方说它是 Luna 的六成五价格、Haiku 5.5 的两成价格,都按五折算。
正价乘以二,六成五变成一百三。
也就是说,二〇二七年五月十七日之后,Code 2 Flash 比它要打的 GPT-6 Luna 还贵三成。对 Haiku 5.5 从两成变四成,仍便宜,但已经不是「便宜一个数量级」。
到那天,Code 2 Flash 的输入输出价和 Haiku 5.5、Luna 完全一样。三家同价的时候,拼的就不是钱,是谁在 Copilot 里更顺手。
Flash 还有个去处:Foundry 的限邀预览,走 OpenAI 兼容的 Responses 接口。注意,只有 Flash,Code 2 没有。
一百零五万上下文,只在两个地方能吃到
模型卡写得很清楚:上下文一百零五万 token,输入上限九十二万二千,输出上限十二万八千,文本加图像,推理五档。
但百万上下文只在 VS Code 和 Copilot CLI 里生效,不是所有 Copilot 界面都给。
权重不发布,模型托管在 Azure 上。宣传里那个 MAI Licensed Weights 是另一件事:可信客户可以拿走模型、用自己的数据微调、跑在自己的 Azure 环境里。这跟「下载权重」差着一个数量级,别混着说。同一天美团把一点六万亿参数的权重直接放了出来(一百九十四张昇腾卡才装得下),两条路的区别一眼可见。
同一场发布会,另外五款里有两款更值得看
Cyber 2 Flash,安全模型。CyberGym-E2E 上九十二点三,GPT-6 Astra 九十一点五,单任务成本不到对方的百分之二,上下文一百万,输出 token 比上一代降了八成六。十二月中旬进 MDASH,不开放通用接口。
这里有个细节值得记:九百零五道题里剔掉了九十二道,理由是开源项目和漏洞报告与训练数据重叠。剔得对不对可以争,但至少写出来了。
Image 2.7 在图像编辑榜上排第一,价格是 GPT Image 2.6 的五分之一,Flash 版一千张十美元。Realtime 1 是微软第一个实时语音模型,一分钟一美分。Transcribe 2 已经在 Dragon Copilot 里每月处理一千万次就诊。Decision 1.1 的底子是谷歌的 Gemma,做路由用,官方说比 Sol 快五十倍、便宜七十九倍。
这一批模型有一个共同点:都是专用模型,不是通用模型。
谁该换,谁别急
该换的是这一类:团队已经在 Copilot 里按用量付费,每天几百次改码、排错、跨文件实现。促销期内成本能砍到四成,质量只差一两个点。模型卡里那句「日常企业编码」,说的就是这活。
别急的是另一类:靠长程智能体连跑几小时的,或者做基础研究的。官方自己承认没往这两个方向调,原话是「明确尚未针对更难的问题调优」。一个模型如果兼着推科学前沿,那每个任务你都得为那份能力付钱,哪怕只是改一个 bug——这句话是微软自己说的,也是这七款模型的共同逻辑。
还有一类必须等:想在自己程序里直接调 Code 2 的。现在只有 Copilot 和 Foundry 两条路,而 Foundry 只给了 Flash。媒体说后续会上 OpenRouter 和 Vercel,但那还是「即将」。
老达点评
微软这次讲的不是模型故事,是账本故事。
它把「通用」拆成「专用」,按活收费,这个方向我认同。企业真正花掉的钱,八成用在日常那些不惊艳的活上,为前沿能力付溢价是一种浪费。
但它自己也掉进了同一个坑:为了把「五分之一」做得好看,用了五折价。打折不是罪,写清楚就行。麻烦在于转述——五折会被抹掉,只剩「便宜二十倍」,等明年五月十七号一到,采购的人打开账单会发现数字翻了一倍,然后开始怀疑所有 AI 报价。
我的判断是:Code 2 值得试,但别按促销价编预算。按正价算它比 Sol 便宜一成九,这仍然是一门好生意,只是没有发布会上那么惊人;轻量那档按正价甚至比 Luna 贵,选型时得重新算一遍。
真正值得盯的是另一件事:模型开始按「一次任务多少钱」报价,而不是「一百万 token 多少钱」。这个口径一旦铺开,采购就没法再拿单价糊弄老板了——同样的活,跑完要花多少,才是能拿去开会说的数。(AI 编程工具专题、AI 工具评测专题)