十一月十八日,Hugging Face 的工程师 Tarek Ziadé 发了一篇博客,标题里两个数字挨在一起,看着不太搭:一千八百亿参数,三十二 G 内存。
跑通的是 Qwen3.8-Flash-Next。四十八层,每层五百一十二个专家,每个词只激活十个。专家权重按 FP8 算是一百二十一 G,另有一张五十一 G 的 n-gram 词表,两个加起来一百七十多 G。
三十二 G 的机器,装一百七十 G 的东西。他没有换机器,换了搬东西的方式。
装不下的是「全部专家」,不是「这次要用的专家」
混合专家模型的省法,靠的是稀疏:五百一十二个专家里,路由器每个词只挑十个,剩下五百零二个这轮不动。按比例算,一层的计算只用到百分之二。
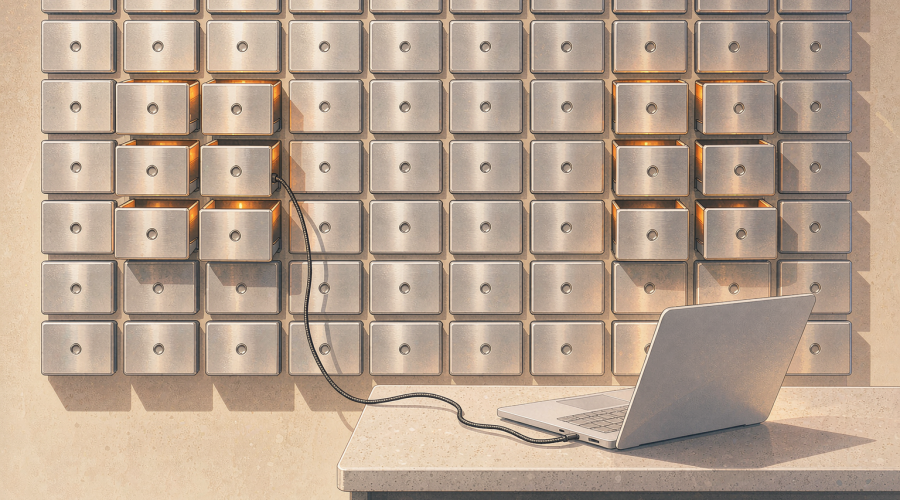
可存储不认这个账。传统卸载方案(比如 Accelerate 里把 device_map 填成 auto 的那句)是模块级搬运:轮到这一层,就把这一层五百一十二个专家的权重整块搬过去,不管路由器最后选了谁。搬完再算,算完再搬回去。
这就好比你要找一份文件,图书馆把整排柜子推到你桌上。
作者在 OLMoE-1B-7B 上先试了最土的办法,一次只搬一个专家,用 Python 循环串起来,每秒只有十点一个词。原生管线是三十二。差三倍。
改法:一块所有层共用的槽位池
真正的改动只有两句话:设备上预分配一块张量,四十八层共用;每层再配一张小表,把专家编号映射到槽位号。
路由器挑出十个专家,编号被重映射成十个槽位号,于是下游那个分组矩阵乘看到的,仍然是一排规整的专家。内核不用重写,只是有些槽位是空的。
没命中的专家从硬盘读。八个读写线程并行,每个专家发一次连续读,不拆碎。缓存有上限,按最近使用淘汰。
还加了预取:算当前层的时候,把下一层、下两层的路由器先跑一遍——反正路由器很便宜——提前把大概率要用的专家拉进来。等真正轮到那一刻,权重已经在路上了。
这套东西现在是一个 Pull Request,编号 50717,还没合并。作者另外发了一个 moe-expert-streaming 包,和一组给苹果芯片预编译好的 Metal 内核。
账单:五小时转换,十八 G 常驻,二十五点四 G 峰值
把一百七十 G 塞进三十二 G,靠三件事。
专家权重压到三比特。落盘四十九 G,设备上留一块十二 GiB 的缓存,装最近用过的那批。
稠密层压到八比特,大约五点四 G,官方测下来困惑度只升百分之零点二。这部分必须常驻,因为它每个词都要算。
那张五十一 G 的 n-gram 词表放硬盘,用哪行读哪行。
离线转换脚本跑五个小时。之后加载完,模型占十八 GiB 左右;喂一个六千词的长提示,峰值到二十五点四 GiB——这个数意味着浏览器得关掉,别的也别开。
一秒十四个词:能读,不能写
生成速度大约每秒十四个词。作者自己的对照是,比 Strata 那个专用引擎慢百分之六以内,预填充还略快一点,从每秒六十八提到二百二十八。
这是他一个人的机器、一个人的配置测出来的,不是第三方评测,也不是平均值。
他自己给了一句评价:这个速度对他的编程智能体工作流来说,太慢了。
这句话比任何跑分都诚实。十四个词一秒,读一篇长文、做一次资料整理、验证一段提示词有没有效,都够用;让智能体在一个仓库里来回改二十个文件,每一步都等这么久,一个下午就没了。
还有一层损耗藏得比较深:每个词大约有十毫秒花在 Python 和显卡之间的往返同步上。差的那百分之六,主要不是算法,是排队。
想自己试:三步,三个坑
三步是:切到那个 PR 分支装 Transformers;装配套包和 Metal 内核;跑完五个小时转换。
三个坑得先说清楚。
第一,它是 PR,不是正式版。接口还在讨论,作者写明了随时会变。今天跑通的脚本,下周可能报错。
第二,硬盘成了瓶颈,也成了损耗件。每生成一个词都在读盘,长时间跑要注意闪存的写入寿命。这一点在博客里没展开,但跑过的人都会想到。
第三,只有苹果能跑顺。Metal 内核是专门给苹果芯片写的,英伟达显卡上的对应版本还没有。想在 Linux 加一张消费级卡上复现,得自己补这一块。
老达点评
这条新闻最容易被误读成「笔记本能跑一千八百亿了」。能跑,但一秒十四个词,这更像「跑通」而不是「能干活」。
真正的成果是另一件事:一台二手的、三十二 G 的苹果笔记本,变成了一个能验证大模型的试验台。你想知道自己那套提示词、那批数据,在一个一千八百亿参数的模型上到底什么表现,以前得排队申请算力,现在插上硬盘就能试。
四天前美团把一点六万亿参数的权重放出来,站内写过,装下它要一百九十四张昇腾卡(一百九十四张昇腾卡才装得下)。同一个月里,一头是机房,一头是笔记本。差别不在硬件参数,在「谁在按需搬权重」这一行代码。
但要清醒:这条路线省的是显存,不是时间。十月的 DGX Spark 把六十四 G 做到四千九百九十九美元(DGX Spark 64GB 降到 4999 美元),RTX Spark 那台笔记本两万三起(笔记本终于能跑七百亿参数),走的是另一条路——花钱买带宽,换速度。两条路都对,只是买的东西不一样:一个买容量,一个买每秒多少词。
我的判断是,现在值得试的是这三类人:手上有苹果机器、想拿大模型验证想法的人;做本地化、数据不能出内网的团队,先跑通再谈优化;以及想读懂推理栈的人,这个 PR 是一份很好的教材,四十八层怎么共用一块显存、预取怎么排,都写在代码里。
别急着试的也是三类:指望它替掉云端写代码的;要跑并发、要接业务的;还有硬盘只剩两百 G 的——光转换就要腾出六十多 G。
最后说一句可能不太讨喜的:这一轮真正的进步是软件,不是硬件。芯片厂卖你显存,开源社区在教你怎么不买。这两件事同时发生,才是今年本地推理最值得记的一笔。(老达AI实践专题、AI 工具评测专题)