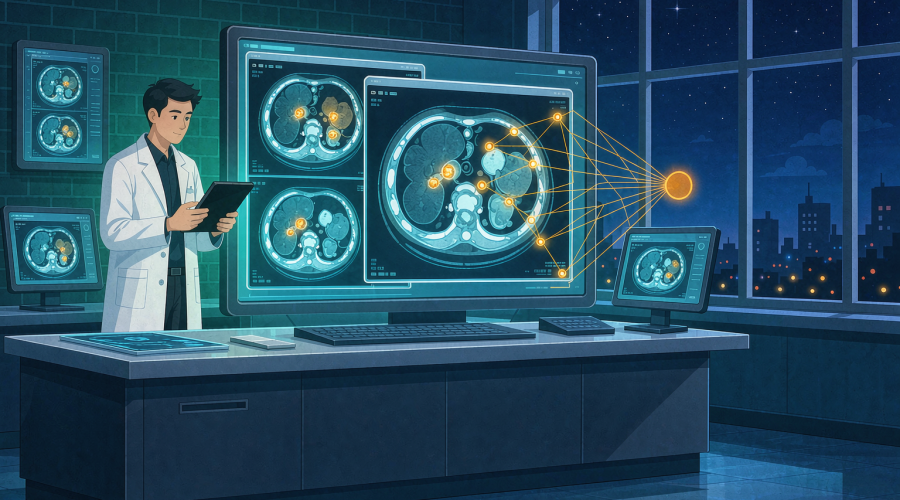
腹部 CT 被称为「最难读的 CT」。几十个器官挤在一起,软组织密度相近,病灶信号又常常很微弱,一位中高级医生写完一份报告要二十分钟到半小时。
9 月 18 日,阿里巴巴达摩院与浙江大学医学院附属第一医院等机构研发的通用医疗影像 AI 模型 DAMO RADAR,登上了国际顶级学术期刊《科学》(Science,第 393 卷 6817 期)。它做的事很直白:从一张腹部增强 CT 里,一次性识别超过 146 种病症,平均 AUC 达到 0.913,与 26 名放射科医生的同场对比中,平均准确率超过了其中 23 名。模型权重、核心代码和整套技术框架已全部开源。
一分钟看懂这件事
先把事实摆清楚:
- 谁做的:阿里巴巴达摩院联合浙江大学医学院附属第一医院等机构,成果发表于《科学》。
- 做什么:面向腹部增强 CT 的通用诊断模型,覆盖 18 个器官、146 种病症,含恶性肿瘤。
- 成绩:近 4 万次真实世界检查中平均 AUC 0.913;与 14 家机构 26 名放射科医生的对比测试中,平均准确率超过 23 名医生。
- 附加价值:在 AI 提示下,医生识别疾病的敏感性(防漏诊能力)提升约 10%,阅片用时缩短 30.7%。
- 开放程度:模型权重、核心代码、全套技术框架已全面开源。
- 泛化表现:训练之外的急诊场景(急腹症)AUC 仍达 0.904。
它做对了什么:从「一病一模」到「一次读全腹」
过去医疗影像 AI 的主流打法是「一病一模」——一个模型只认一种病。肺结节一个模型,胰腺癌一个模型,糖尿病视网膜病变一个模型。达摩院高级算法专家张建鹏有个挺形象的比喻:单病种 AI 就像专攻个别题型的学生,固定题型考得极好,换一类题就无从下手。
这条路还有两个硬成本:训练严重依赖人工标注,而且通常每针对一种疾病就要两年,训完之后无法泛化到别的病种。面对真实临床里一个人同时有好几种问题的复杂情况,一病一模实在忙不过来。
DAMO RADAR 换了思路,用的是视觉—语言学习:不再依赖医生逐张勾画病灶,而是让模型直接学习 CT 影像和对应诊断报告之间的关联。但 CT 是三维数据、有效信号又稀疏,常规的视觉—语言学习直接套上去效果不好。
于是研究团队在国际上首次提出「器官级细粒度对齐」——借鉴放射科医生阅片时按解剖结构依次核查肝脏、胰腺、胆道等器官的顺序,把三维 CT 拆解成独立的器官级解剖单元,在器官和组织层面让影像与报告文本精准对应,再配合自适应对比建模动态调整学习过程。结果是:不需要额外人工标注,就能扩展到更多诊断任务,而且判断路径更容易理解和追溯。
如果你对这套「让模型同时学图和文」的技术路线感兴趣,站内这篇讲多模态大模型(MLLM)的百科可以先补一下底子。
数字拆开看:0.913 和「赢了 23 位医生」意味着什么
这两个数字最容易被误读,值得单独说清楚。
AUC 0.913 是什么:AUC 衡量的是模型把患病和正常区分开的能力,越接近 1 越好,0.5 相当于瞎猜。0.913 是在近 4 万例连续临床病例、146 种病症上得到的平均值——不是挑了好做的病,而是把 18 个器官的病种一起算。
「赢了 23 位医生」是怎么比的:研究团队请来 14 家机构的 26 名影像科医生,其中 11 名资深、15 名初级,医生和模型分别对 300 名患者的 CT 影像做判断。结论是模型的平均准确率超过其中 23 名。注意措辞——是「平均准确率超过」,不是「全面替代」,也不是在每一种病上都赢。
更值得关注的是协作效果:在 AI 提示下,放射科医生的敏感性提升约 10%,阅片时间缩短 30.7%,低年资医生的诊断水平被拉到了高年资医生的水平。这三条比单看排名更有意义,因为它们描述的是人机配合后的结果,而不是把医生换掉。
为什么这件事对普通人和基层医院是好事
浙大一院放射科主任肖文波有三十多年从业经验,她的判断是:腹部 CT 诊断是最具挑战的影像科任务,长期缺乏一种通用的辅助诊断模型,DAMO RADAR 首次实现了腹部多器官、多病种的高准确检出,能像「导航」一样为医生提供诊断支持。
「导航」这个定位抓得很准。基层医院的痛点是阅片量有限、医生临床经验相对不足,而腹部 CT 的阅片难度恰恰更高——阅片量上不去,经验就积累不起来。一个能达到专家级平均水准的通用模型,最先受益的可能不是三甲医院,而是那些最缺专家的地方。
从更长的脉络看,达摩院这块的积累也不是突然冒出来的:三年间发表了 1 篇《科学》、5 篇《自然·医学》和其他十余篇顶刊论文,从胰腺癌、胃癌、肠癌等消化系统肿瘤筛查,到主动脉夹层预警,一直在把单病种能力往真实临床推。这次开源 RADAR,相当于把能力从「单个病种、单个团队」放出来,让更多医疗机构和研究团队去用、去验证、去扩展。
老达点评
第一,「通用」比「更强」更值钱。 医疗影像 AI 过去十年最不缺的就是单病种 SOTA,缺的是能同时应付十几种异常、还能在训练之外保持稳定的模型。器官级对齐这个思路的价值不在跑分,而在于它把「怎么让模型规模化地学更多病」的成本结构改了——少依赖人工标注,多利用医院本来就有的报告文本。这个思路大概率会被搬到其他影像领域去。
第二,它是导航,不是替班。 敏感性和用时这两个指标比准确率排名更重要,因为它们说的是诊断流程被改进了,而不是诊断责任被转移了。腹部 CT 报告最终仍然要有资质的医生签字,AI 提示的每一条异常都要能被复核。谁把「AI 说没事」当成免责理由,谁就是在给自己挖坑。
第三,「开源权重」离「用起来」还有很长一段路。 权重和代码开源,解决的是研究者和厂商能不能复现、能不能二次开发的问题。但要把模型放进医院,真正卡人的是数据接入、影像序列标准化、院内系统对接、以及最关键的——数据合规和责任界定。这几道关不会因为代码是开源的就不存在。
第四,看数字也要看边界。 「平均准确率超过 23 名医生」是个很漂亮的表述,但临床最怕的从来不是平均水平,而是那些罕见的、不典型的、模型没见过的病例。模型在急腹症上的 AUC 0.904 是泛化能力的一个好信号,但这只能说明方向对,不能说明它已经覆盖了全部真实场景。
如果你还想从更大一点的视角看 AI 怎么进入医疗和健康管理这个领域,站内之前那篇AI 辅助医疗:人工智能如何改变看病和健康管理有一份更完整的梳理;想了解国产开源模型这一年的整体格局,2026 大模型格局重构值得翻一翻。
多模态能力这一年的进步速度也值得对照着看——上周阿里 Qwen3.8-Omni-Flash 刚把音视频输入的价格打到原来的零头,一次看完两小时视频那篇里有具体数字。医疗影像走的是另一条更慢但更重的路:榜单不认价格,只认临床验证。
想持续跟进 AI 在真实行业里的落地案例,可以顺着老达 AI 实践专题和 AI 工具评测专题往下翻,前者看场景,后者看工具本身。