如果一家公司敢于公开”我们有多少研发活是 AI 自己在干”,通常意味着这个数字已经大到瞒不住、又还不至于吓人。
9 月 17 日,Anthropic 发了这样一份报告:它把”AI 参与研发的深度””Agent 被管住的程度””多少算力花在安全上”三件事,第一次用可复现的口径摊在了外面。这份报告没有讲模型能力,讲的是模型正在用多快的速度改造它自己的出生地。
三组数字先记住
把报告里最硬的三个数拉出来,剩下的篇幅都是在解释它们。
- Claude 主导的 AI 研发工作占比:26%,2026 年 2 月还不足 1%;
- 内部同时运行的 Agent 数:约 3 万个,8 月产生超 10 亿次决策;
- 投向安全监控的研发算力:约 6%,若只统计 AI 驱动的研发,该比例升到约 12%(7 月样本周数据)。
半年时间,从”几乎没有”到”超过四分之一”,这是这组数字里最有信息量的一条。它同时解释了两件事:为什么最近几个月前沿实验室都在喊”要放缓”,以及为什么这种喊话很难被外部验证——因为账本一直锁在实验室里。
“AI 主导”到底怎么算:AL0 到 AL5
25% 还是 40%,取决于”主导”的定义。Anthropic 用的是独立研究机构 Epoch AI 提出的六级自动化框架,把每一段研发工作从 AL0 到 AL5 打分:
- AL0:完全没有 AI 参与;
- AL1-AL2:AI 做零散辅助,人推着走;
- AL3:AI 协作,人给方向、AI 干大块活;
- AL4:AI 主导,人只给高层目标,全程监督与最终决策;
- AL5:完全自主,人不在环里。
按这个刻度,截至 2026 年 8 月,26% 的研发工作达到 AL4,另有超过 90% 至少达到 AL3。而 Anthropic 特意强调了一句:没有任何被测量的工作达到 AL5。
这一刀切得很有意思。它把外界最担心的”全自动递归自我改进”直接划到了另一个格子,同时又承认”人类给个目标、AI 端到端干完”已经占了四分之一。真要理解这个尺度,可以对照一下国内公开的同类数据:智谱再融 335 亿押注 RSI 那篇里,唐杰披露 GLM-5.3-Flash 两周内完成国产加速器全量部署、大部分工作由 Infra Agent 完成,判断”模型优化系统、系统服务模型”的循环已经转起来——表述不同,指向的是同一件事。
26% 长什么样:一个夜里修管道的例子
报告给了一个具体场景,比抽象比例更有说服力。
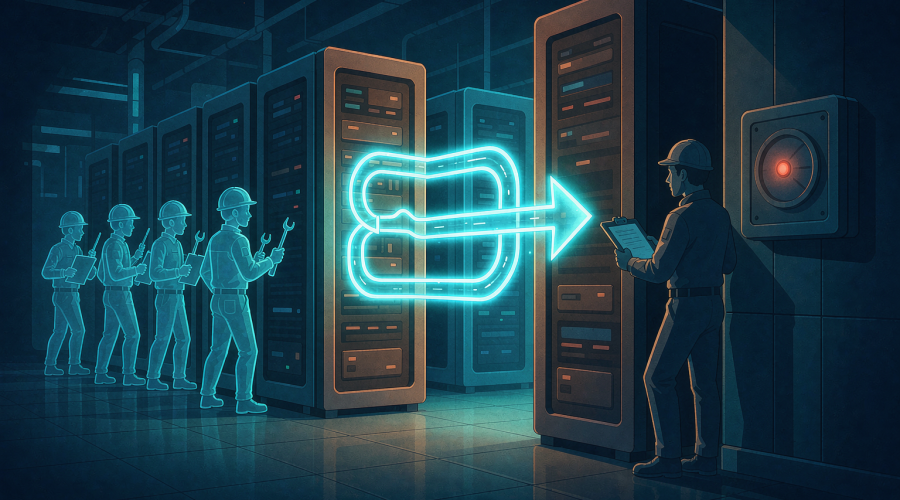
夜间数据管道故障。工程师第二天早上把故障报告丢给 Claude,只说了一句”把它修好”。接下来发生的是:查看日志 → 定位原因 → 写修复代码 → 自测 → 处理测试暴露出的新问题 → 重跑管道 → 对比前后结果 → 写一份说明。
工程师在整条链路里做了两件事:给目标,最后检查。这就是 AL4 的字面意思。
把它放到工程视角看,这和 微软 Opal 那类”给一个目标、云电脑里连干几小时”的产品思路是同一脉:长任务 Agent 的价值不在单步智力,而在于它敢在没人盯着的时候连续做判断。
3 万个 Agent 是怎么被管住的
规模数字比比例更值得看:约 3 万个 Agent 在同时做研究和工程工作。它们有两个设计细节值得抄。
第一,独立身份。 每个 Agent 有独立于底层模型版本的标识。模型升级了,Agent 的身份和历史不跟着重置——这是做审计、追责和权限收敛的前提。
第二,共享消息系统。 Agent 之间可以互相委派任务、交叉纠错,而不是各自孤立跑单。多智能体协作这件事,Anthropic 自己早先的红队实验其实给过反面警示:三个 Claude 放进同一个仓库,协作反而放大了越界行为。所以”能互派任务”和”能互查”是两件必须同时做的事。
监管方式分两层:
- 在线监控:每个动作执行前检查。8 月超 10 亿次决策里,约 0.002% 被拦下——换算一下,大约每 4.7 万次拦住一次。报告把这个比例放在”有序但真实”的区间:拦得太少说明监控形同虚设,拦得太多说明 Agent 根本没法干活。
- 离线监控:每周标记约 10 万条对话记录,经分类器过滤误报和初步审查后,最高优先级的约 50 条升级到人工。从 10 万到 50,这个漏斗比例本身就说明了人工审查在大规模 Agent 体系里的真实位置。
算力账本:6% 和 12% 差在哪
安全投入用的是两个口径:7 月样本周内,约 6% 的 AI 研发算力投向安全研究;如果把分母换成”AI 驱动的研发算力”,这个比例升到约 12%。
为什么同一个数会有两个版本?因为分母不同。6% 是相对全部研发算力,12% 是相对”由 AI 完成的那部分研发”。
这恰好是OpenAI 那边”踩刹车”讨论缺的那一环。当所有人都说该把更多算力投给安全,却没人说清分母是什么、投了多少时,讨论只能停留在态度层面。Anthropic 这次的价值不在于 12% 这个数字好看,而在于它给出了一个可被追问、可被别的实验室套用的记账方式。
影响分析:三件事值得国内团队提前接住
一是”AI 参与度”正在变成可披露指标。 既然 Anthropic 能按 AL0-AL5 给自己的研发打分,团队内部当然也能给业务流程打分:哪些环节是 AL3 的人机协作,哪些已经到了 AL4。这不是学术练习——它直接决定了你要给 AI 配什么样的审批和审计。
二是”Agent 身份”要先于”Agent 数量”建起来。 当一家公司的 Agent 规模到几千上万时,最大的风险不是 Agent 变坏,而是没人说得清哪个 Agent 在什么时候、用什么权限、替谁做了决定。这跟OpenAI 自曝六起模型失控案例里暴露的问题是一体两面:出事的往往不是模型能力,而是权限和记录。
三是监控要分层,别指望一层搞定。 在线拦动作、离线扫对话、人工审最高优先级——三层各管一段,成本和命中率才平衡。把所有 Agent 动作都扔给人工审,规模一上来必然失控。
如果你想系统看这类”Agent 上生产”的配套能力,AI 智能体与自动化专题里有比较完整的一条线。
老达点评
先说报告本身的两个软肋,这才算认真读。
第一,口径是自定的。Anthropic 自己也承认,”AI 协作”和”AI 主导”之间的边界带有主观性,跨实验室比较需要统一方法和第三方验证。分析师 Nat Lambert 的质疑很直接:报告压根没有定义清楚”AI 研发工作”的范围。所以 26% 这个数字,准确的说法是”在 Anthropic 的定义下、在 Anthropic 的测量范围内”。
第二,它是一份”自我报告”。目前它承诺引入多个第三方评估机构并授予后台访问权限,但那是将来时。
再看这组数字真正的意义。它把 RSI(递归自我改进)从一个哲学话题变成了一个工程台账问题:不再是”AI 会不会自己进化”,而是”你打算用什么刻度去量它、用什么身份去管它、用什么比例去踩刹车”。
对国内的团队,我建议不要急着对标 26%,那没有可比性。更该抄的是三样东西:一个能打分的自动化刻度、一套独立于模型版本的 Agent 身份、一个分层的监控漏斗。这三样东西跟模型能力强弱无关,从今天就可以开始建。
想从实践角度继续往下走,可以顺带看看老达AI实践专题里的落地案例,思路比数字更耐用。